

 @MC33


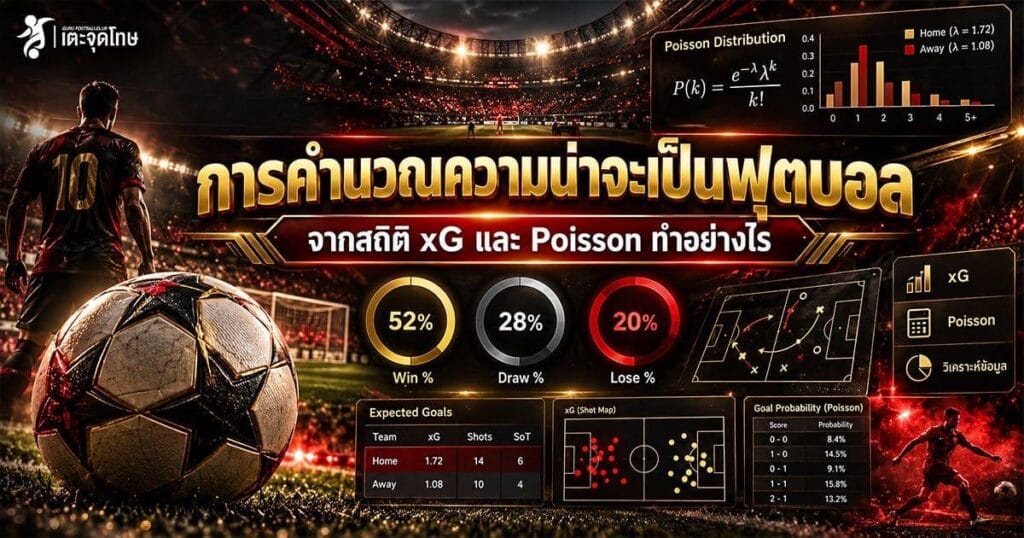
การคำนวณความน่าจะเป็นฟุตบอล คือกระบวนการเปลี่ยนข้อมูลการแข่งขันให้เป็นค่าประมาณว่าเหตุการณ์หนึ่งมีโอกาสเกิดมากน้อยเพียงใด เช่น เจ้าบ้านชนะ เสมอ ทีมเยือนชนะ จำนวนประตูเกิน 2.5 หรือทั้งสองทีมทำประตู โดยสามารถเริ่มจาก Historical Frequency แบบง่าย ไปจนถึง Statistical Model อย่าง Poisson ที่นำ Expected Goal Rate ของแต่ละทีมมาสร้าง Goal Distribution
จุดสำคัญคือ Probability ที่ได้ไม่ใช่ผลการแข่งขันที่ทราบล่วงหน้า แต่เป็น Estimate ภายใต้ข้อมูลและสมมติฐานของ Model หาก Sample เล็ก ค่า λ ไม่เหมาะสม Lineup เปลี่ยน หรือ Model ไม่ผ่าน Calibration ตัวเลขที่ดูละเอียดก็อาจสร้างความมั่นใจเกินจริงได้
Framework ของบทนี้คือ:
Data → Team Strength → Expected Goal Rate → Probability Distribution → Outcome Probability → Calibration → Uncertainty
และต้องแยกออกจาก Market-Implied Probability ซึ่งมาจาก Odds ไม่ใช่ Independent Estimate ที่สร้างจากข้อมูลฟุตบอล
Probability คือค่าที่แสดงความน่าจะเป็นของเหตุการณ์ โดยอยู่ระหว่าง:
0 ถึง 1
หรือ:
0% ถึง 100%
ตัวอย่าง Model หนึ่งอาจประเมินการแข่งขันว่า:
| Outcome | Probability |
| Home Win | 50% |
| Draw | 27% |
| Away Win | 23% |
หากสาม Outcome นี้ครอบคลุมผลการแข่งขันทั้งหมดและไม่ทับซ้อนกัน ผลรวมควรเท่ากับประมาณ:
100%
แต่คำว่า 50% ไม่ได้หมายความว่าเจ้าบ้าน “จะชนะ”
หมายความว่า Model ประเมิน Outcome นี้ไว้ที่ระดับประมาณครึ่งหนึ่งภายใต้ข้อมูลและสมมติฐานที่ใช้
Prediction แบบทั่วไปอาจตอบว่า:
ทีม A น่าจะชนะ
แต่ Probability Forecast ตอบว่า:
Team A Win 52%, Draw 27%, Team B Win 21%
แบบหลังเก็บความไม่แน่นอนไว้ในคำตอบ
แม้ Team A จะเป็น Outcome ที่มี Probability สูงสุด แต่:
52% ไม่ใช่ Certainty
ยังมี Probability รวมอีก 48% สำหรับ Draw และ Away Win
นี่คือเหตุผลที่ Model สำหรับฟุตบอลควรสนใจ คุณภาพของ Probability ไม่ใช่เพียงจำนวน Match ที่ทายฝั่งชนะถูก
ไม่ควรตีความว่า:
“ทีมนี้จะชนะ”
ความหมายที่เหมาะกว่าคือ:
หาก Model ให้เหตุการณ์ที่ Comparable กันจำนวนมากอยู่ใกล้ 55% และ Model มี Calibration ที่ดี เหตุการณ์ในกลุ่มนั้นควรเกิดใกล้ 55% ในระยะยาว
การตรวจลักษณะนี้เรียกว่า Probability Calibration ซึ่งเป็นเรื่องสำคัญมากกว่าการดูว่า Prediction หนึ่งครั้งถูกหรือผิด
วิธีพื้นฐานที่สุดคือ:
Historical Frequency = จำนวนครั้งที่เหตุการณ์เกิด ÷ จำนวน Observations
ตัวอย่าง:
ทีมชนะ 6 จาก 10 เกม
6 ÷ 10
= 60%
ตัวเลขนี้เรียกได้ว่า Historical Win Rate ของ Sample นั้น
แต่ไม่ควรเปลี่ยนประโยคเป็น:
“เกมหน้าทีมนี้มีโอกาสชนะ 60%”
ทันที
เพราะ Match ใหม่มี Context ใหม่
สมมติทีมมี:
Overall Last 10:
6W-2D-2L
Win Rate = 60%
แต่แยกออกมาเป็น:
Home 5 นัด = 5W
Away 5 นัด = 1W-2D-2L
หาก Match ใหม่เป็นเกมเยือน การใช้ Overall Win Rate 60% เพียงตัวเดียวอาจซ่อน Venue Effect
นอกจากนี้ Match ใหม่ยังมี:
ดังนั้น:
Historical Frequency ≠ Next-Match Probability
เป็นหลักแรกที่ควรจำ
เปรียบเทียบ:
ทีม A ชนะ 3 จาก 3
= 100%
ทีม B ชนะ 70 จาก 100
= 70%
100% ดูสูงกว่า
แต่ Evidence Base ของ 3 Matches เล็กกว่ามาก
หากทีม A แพ้เกมถัดไป:
3/4 = 75%
เพียง Match เดียวทำให้ Frequency ลดลง 25 Percentage Points
Sample เล็กจึงมี Variance สูง และไม่ควรถูกตีความว่าเป็น Probability ที่แม่นยำกว่าเพียงเพราะเปอร์เซ็นต์สูง
ไม่มี Sample เดียวที่ดีที่สุดทุกสถานการณ์
| Sample | หน้าที่ |
| Last 5 | Recent Form |
| Last 10 | Medium-term Trend |
| Season | Baseline |
| Multi-season | Prior ระยะยาวในบาง Model |
Last 5 สดกว่าแต่ผันผวนกว่า
Season มีข้อมูลมากกว่า แต่อาจรวมช่วงก่อนเปลี่ยนโค้ชหรือผู้เล่น
สิ่งสำคัญคือไม่ควรเปลี่ยน Sample ไปเรื่อย ๆ จนได้ตัวเลขที่สนับสนุน Conclusion ที่ต้องการ
อ่านเพิ่มเติม: ฟอร์ม 5 นัดล่าสุด
สำหรับ Decimal Odds:
Raw Implied Probability = 1 ÷ Odds × 100
ตัวอย่าง:
Odds 2.00
= 50%
Odds 1.80
≈ 55.56%
Odds 2.50
= 40%
แต่ตัวเลขนี้คือ:
Market-Implied Probability
ไม่ใช่ Independent Probability จาก Team Data
การเดิมพันหลายตลาดยังมี Margin ของผู้ให้บริการ จึงไม่ควรเรียก Raw Implied Probability ว่า Fair Probability ทันที
ตัวอย่างตลาด 1X2:
Home @ 2.00
Draw @ 3.50
Away @ 4.00
คำนวณ:
Home = 50.00%
Draw ≈ 28.57%
Away = 25.00%
รวม:
103.57%
ส่วนที่เกิน 100% คือ Overround ในการคำนวณพื้นฐาน
จึงต้องระวังไม่เอา 50%, 28.57% และ 25% ไปเรียกว่า Fair Probability ของตลาดโดยไม่ปรับ Margin
วิธีพื้นฐานคือ Normalize ตามสัดส่วน:
No-Vig Probability = Raw Probability ÷ ผลรวม Raw Probabilities
จากตัวอย่าง:
Home:
50 ÷ 103.57
≈ 48.28%
Draw:
28.57 ÷ 103.57
≈ 27.59%
Away:
25 ÷ 103.57
≈ 24.14%
รวมประมาณ 100%
แต่ Proportional Normalization เป็นเพียงวิธีประมาณหนึ่ง ไม่ได้พิสูจน์ว่าผู้ให้บริการกระจาย Margin ให้ทุก Outcome ในสัดส่วนเดียวกันจริง
อ่านเพิ่มเติม: วิเคราะห์ความคุ้มค่าราคาบอล
นี่คือจุดแบ่ง Intent สำคัญของบท
Market Probability
สร้างจาก Odds
Independent Probability
สร้างจาก Match Data หรือ Statistical Model โดยไม่ใช้ Price เป็นคำตอบหลัก
เหตุผลที่ต้องแยกสองอย่างนี้คือ หากนำ Odds มาคำนวณ Probability แล้วใช้ Probability เดิมกลับไปพิสูจน์ว่า Odds นั้นคุ้มหรือไม่ จะเกิด Circular Reasoning
Workflow ที่เหมาะกว่าคือ:
Match Data → Independent Probability
จากนั้นค่อย:
Independent Probability → Compare with Market
ก่อนเข้าสู่สูตร Poisson ให้แบ่งข้อมูลเป็นสองส่วนใหญ่
อาจใช้:
อาจใช้:
จากนั้นตรวจ Context เพิ่ม เช่น:
ตัวเลขเหล่านี้ยังไม่ใช่ Probability
หน้าที่ของ Model คือเปลี่ยนข้อมูลเหล่านี้ให้เป็น Parameter ที่สามารถสร้าง Distribution ได้
ฟุตบอลมี Venue Effect
สมมติ Team A:
Overall GF/Game = 1.70
Home GF/Game = 2.10
Away GF/Game = 1.30
หาก Match ใหม่เป็น Home การใช้ค่า Overall อย่างเดียวอาจลดข้อมูลเรื่อง Venue ที่มีอยู่แล้ว
Model แบบพื้นฐานจึงมักแยก:
Home Attack
กับ:
Away Defence
จากนั้นทำกลับกัน:
Away Attack
กับ:
Home Defence
อ่านเพิ่มเติม: วิเคราะห์สถิติเหย้าเยือน
xG วัด Probability ของ Shot ที่จะเป็นประตู โดย xG Model ใช้ข้อมูล Shot Historical และ Features เช่นระยะยิง มุม Body Part และประเภทของการสร้างโอกาส ทั้งนี้แต่ละ Provider สามารถใช้ Features ต่างกันและให้ค่าต่างกันได้
ดังนั้น:
xG 2.0 ≠ Win Probability 200%
และ:
xG 2.0 ≠ ทีมจะยิง 2 ประตูแน่นอน
xG สามารถใช้เป็น Input เพื่อประมาณ Expected Goal Rate
จากนั้น Goal Rate จึงถูกแปลงเป็น Goal Distribution
อ่านเพิ่มเติม:
Poisson Distribution เป็น Probability Distribution สำหรับจำนวนเหตุการณ์ที่เกิดขึ้นในช่วงหนึ่ง ภายใต้สมมติฐานของ Model
Probability Mass Function คือ:
P(X = k) = (e^-λ × λ^k) ÷ k!
โดย:
SciPy ระบุสูตร Probability Mass Function ของ Poisson ในรูปเดียวกัน และค่าเฉลี่ยของ Distribution เท่ากับ λ
Poisson และ Poisson Regression มีประวัติการใช้งานใน Football Score Modeling เช่นงานของ Dixon และ Coles ที่พัฒนา Model สำหรับสกอร์ฟุตบอลอังกฤษ โดยปรับข้อจำกัดของ Simple Poisson เพิ่มเติม
สมมติทีมหนึ่งมี Expected Goal Rate:
λ = 1.50
Poisson ให้ Probability โดยประมาณ:
| Goals | Probability |
| 0 | 22.31% |
| 1 | 33.47% |
| 2 | 25.10% |
| 3 | 12.55% |
| 4 | 4.71% |
สิ่งสำคัญคือ:
Expected Goals 1.50 ไม่ได้หมายความว่าสกอร์จะเป็น 1.5 ลูก
แต่หมายถึง 1.50 เป็น Parameter ที่กำหนดรูปทรงของ Goal Distribution
สูตร Poisson ไม่ใช่ส่วนที่ยากที่สุด
ส่วนที่ยากกว่าคือ:
λ ควรเป็นเท่าไร?
Basic Model สามารถเริ่มจาก League Baseline และ Team Strength
เช่น:
Home Attack Strength = Team Home Goals/Game ÷ League Home Goals/Game
สมมติ:
Team Home GF = 1.80
League Home GF Average = 1.50
Attack Strength:
1.80 ÷ 1.50
= 1.20
หมายความว่าทีมทำประตูในบ้านใน Sample นี้ประมาณ 1.20 เท่าของ League Baseline
ไม่ได้หมายความว่าทีม “เก่งกว่า 20%” ในภาพรวม
สมมติทีมเยือนเสีย:
Away GA = 1.65 ต่อเกม
League Home Scoring Average = 1.50
Defensive Concession Factor:
1.65 ÷ 1.50
= 1.10
จากนั้น Simple Model อาจนำ:
มาประกอบกันเพื่อสร้าง Home λ
และทำในทิศตรงข้ามเพื่อสร้าง Away λ
นี่เป็นเพียง Model แบบพื้นฐาน ไม่ใช่สูตรมาตรฐานเดียวที่ทุกระบบต้องใช้
สมมติมีสอง Model
Model A:
Poisson Formula ถูกต้องมาก
แต่ λ ถูกสร้างจาก Last 3 Match อย่างเดียว
Model B:
ใช้สูตรเดียวกัน แต่ λ ผ่านการปรับ:
Distribution ที่ออกมาอาจแตกต่างกันมาก
ดังนั้น:
Poisson ไม่สามารถแก้ Input ที่อ่อนให้กลายเป็น Probability ที่ดีได้
นี่เป็นหนึ่งในข้อสำคัญที่สุดของบท
สมมติ:
Home λ = 1.50
Away λ = 1.00
เราคำนวณ Probability ที่แต่ละทีมยิง:
0, 1, 2, 3, 4… ประตู
จากนั้นภายใต้ Simple Model ที่สมมติ Goal Counts เป็นอิสระ:
P(Home 1 – Away 0)
=
P(Home=1) × P(Away=0)
ทำแบบเดียวกันทุก Score แล้วสร้าง Score Matrix
| Home \ Away | 0 | 1 | 2 | 3 |
| 0 | P00 | P01 | P02 | P03 |
| 1 | P10 | P11 | P12 | P13 |
| 2 | P20 | P21 | P22 | P23 |
| 3 | P30 | P31 | P32 | P33 |
Matrix นี้เป็นฐานสำหรับคำนวณหลาย Market Probability จาก Model เดียว
รวม Score ทั้งหมดที่:
Home Goals > Away Goals
เช่น:
1-0
2-0
2-1
3-0
3-1
3-2
4-0
ฯลฯ
รวม Probability ของ:
0-0
1-1
2-2
3-3
4-4
ฯลฯ
รวมทุกช่องที่:
Away Goals > Home Goals
หาก Matrix รวม Score ไปถึงจำนวนประตูที่สูงเพียงพอ:
Home Win + Draw + Away Win ≈ 100%
หากตัด Matrix ที่ 3 หรือ 4 ประตู ต้องระวัง Probability Tail ที่ยังอยู่นอกตาราง
Over 2.5 ต้องการ:
Total Goals ≥ 3
จึงรวม Score เช่น:
2-1
1-2
3-0
0-3
2-2
3-1
ฯลฯ
ส่วน Under 2.5 รวม:
0-0
1-0
0-1
1-1
2-0
0-2
อ่านเพิ่มเติม: วิเคราะห์ประตูสูงต่ำ
BTTS Yes หมายถึงทั้งสองทีมยิงอย่างน้อยหนึ่งประตู
จาก Score Matrix สามารถรวมทุกช่องที่:
Home ≥ 1
และ:
Away ≥ 1
สำหรับ Independent Poisson ยังเขียนได้เป็น:
P(BTTS Yes) = 1 – P(Home=0) – P(Away=0) + P(0-0)
อ่านเพิ่มเติม: ทั้งสองทีมทำประตู คืออะไร
สามารถสร้าง Model ที่ใช้:
แทน Actual Goals หรือใช้ร่วมกัน
ข้อดีคือ xG พยายามจับ Chance Quality แทนการพึ่ง Conversion ที่ผันผวนระยะสั้น
แต่ต้องตรวจ:
Hudl StatsBomb ระบุชัดว่า xG Model ต่าง Provider สามารถประเมิน Shot เดียวกันต่างกัน เพราะ Features ที่ใช้ไม่เหมือนกัน
จึงไม่ควรนำ xG จากหลาย Provider มาผสมโดยไม่ตรวจ Methodology
ไม่มี Weight สากล เช่น:
Goals 40% + xG 60%
ที่พิสูจน์ว่าเหมาะกับทุก League และทุก Model
หากสร้าง Weight ควร:
ไม่ควรเลือก Weight เพราะทำให้ Historical Results ที่ใช้สร้าง Model ดูดีที่สุด
เพราะนั่นเพิ่ม Overfitting Risk
สมมติทีมยิง:
10 Goals
จาก:
4.5 xG
ใน Sample สั้น
ไม่ควรสมมติว่าทีมจะยิงเกิน xG ในอัตราเดิมต่อไปโดยอัตโนมัติ
Regression to the Mean เป็นแนวคิดว่าค่าที่ Extreme ใน Sample สั้นอาจเคลื่อนกลับเข้าใกล้ Baseline เมื่อ Sample เพิ่ม
แต่ไม่ควรใช้แบบตายตัวว่า:
“ยิงเกิน xG แล้วต้องยิงน้อยลงเกมหน้า”
เพราะ Skill, Shot Selection และ Context ยังมีผล
แนวคิดแบบ Bayesian ที่ใช้ได้ง่ายคือ:
เริ่มจาก Prior
เช่น:
Season Baseline หรือ Long-term Team Strength
จากนั้นค่อย Update ด้วย:
New Evidence
เช่น Last 5
แทนที่จะทิ้ง Baseline แล้วใช้ Last 3 อย่างเดียวทันที
ตัวอย่าง:
Season Attack Level = ปานกลาง
Last 3 = สูงมาก
แนวคิด Bayesian จะถามว่า New Evidence มากพอที่จะเปลี่ยน Prior แค่ไหน
นี่ช่วยลด Reaction ต่อ Small Sample
อาจมี
Model สามารถใช้ Time Decay ให้ Match ล่าสุดมี Weight มากกว่า Match เก่า
แต่คำถามคือ:
Decay Rate เท่าไร?
นั่นเป็น Model Choice
ถ้าเลือกค่า Decay เพราะ Backtest ชุดเดิมดูดีที่สุดโดยไม่ทดสอบข้อมูลใหม่ ก็ยังเสี่ยง Overfitting
ดังนั้น Weight ของ Recency ควรถูก Validate
ทีมที่ชนะ 5 นัดจากคู่แข่งท้ายตารางไม่ควรถูก Treat เท่ากับทีมที่ทำผลงานเดียวกันจากคู่แข่งระดับบน
สามารถแก้โดย:
เป้าหมายคือไม่ให้ Raw Result ถูกตีความโดยไม่มี Difficulty Context
อ่านเพิ่มเติม: วิธีวิเคราะห์เดิมพันฟุตบอล
ไม่ควรสร้าง Rule เช่น:
กองหน้าหลักไม่ลง = ลด 10%
หากไม่มีหลักฐานรองรับ
สามารถใช้ข้อมูลเช่น:
หากยังไม่มี Model สำหรับ Player Adjustment ที่ Validate ดี วิธีที่ซื่อสัตย์กว่าคือสะท้อน Lineup ผ่าน:
Uncertainty Range
แทนการสร้าง Percentage Adjustment ที่ดูแม่นเกินจริง
Point Estimate:
Home Win = 55%
ใช้ง่าย
แต่หาก Match มีความไม่แน่นอนสูง อาจรายงาน:
Central Estimate = 55%
Plausible Range = 50–60%
โดยเฉพาะเมื่อ:
ช่วงดังกล่าวไม่ได้ทำให้ Model ถูกแน่นอน แต่ช่วยแสดงว่าค่า 55% ไม่ใช่ตัวเลขที่รู้ด้วยความแม่นยำสมบูรณ์
ไม่ควรใช้สองคำนี้แทนกัน
Confidence Interval
มีความหมายทางสถิติที่ต้องมาจาก Method เฉพาะ
หากช่วง 50–60% มาจาก:
ควรเรียกว่า:
Plausible Range
หรือ:
Estimated Range
จะตรงกว่า
Calibration ตรวจว่าค่า Probability ของ Model สอดคล้องกับ Observed Frequency หรือไม่
ตัวอย่าง:
Model มี Forecast จำนวนมากใกล้ 60%
หาก Model Calibrated ดี Outcome ในกลุ่มนี้ควรเกิดใกล้ประมาณ 60% เมื่อ Sample ใหญ่เพียงพอ
scikit-learn อธิบายว่า Classifier ที่ Calibrate ดีและให้ Probability ใกล้ 0.8 ควรเห็น Positive Class ประมาณ 80% ในกลุ่มดังกล่าว
Calibration จึงตอบคำถามว่า:
ตัวเลข 60% เชื่อถือในฐานะ 60% ได้เพียงใด
| Predicted Probability | Observed Frequency |
| 40–45% | ตรวจจาก Sample |
| 45–50% | ตรวจจาก Sample |
| 50–55% | ตรวจจาก Sample |
| 55–60% | ตรวจจาก Sample |
| 60–65% | ตรวจจาก Sample |
หาก Forecast กลุ่ม 60–65% เกิดจริงเพียง 45% ซ้ำ ๆ Model อาจ Overconfident
หากเกิดใกล้ช่วงที่ Forecast ไว้มากขึ้น Calibration จะดีกว่า
Model อาจเลือก Outcome ที่มี Probability สูงสุดได้ถูกบ่อย แต่ Probability ยังไม่ Calibrated
ตัวอย่าง:
Model ชอบให้ Favorite:
90%
แต่ Favorite เหล่านั้นเกิดจริงเพียงประมาณ:
65%
Model อาจมี Direction ที่ใช้ได้ แต่ Confidence รุนแรงเกินไป
ดังนั้น Probability Model ควรประเมินมากกว่า:
Prediction Accuracy
สำหรับ Binary Outcome:
Brier Score = (Forecast Probability – Actual Outcome)²
Actual Outcome:
เกิด = 1
ไม่เกิด = 0
ตัวอย่าง:
Forecast = 0.70
Outcome เกิด = 1
Brier:
(0.70 – 1)²
= 0.09
โดยทั่วไป Score ต่ำกว่าดีกว่าเมื่อเปรียบเทียบบน Dataset และ Context ที่เหมาะสม
อย่างไรก็ตาม scikit-learn เตือนว่า Brier Score สะท้อนทั้ง Calibration, Discrimination และ Uncertainty จึงไม่ควรใช้คะแนนเดียวแทน Calibration Curve ทั้งหมด
Log Loss เป็นอีก Metric สำหรับ Probability Forecast และลงโทษกรณีที่ Model มั่นใจมากแต่ผิดอย่างหนัก
scikit-learn นิยาม Binary Log Loss จาก Probability p และ Actual Outcome y ด้วย Negative Log-Likelihood
ในบทระดับพื้นฐานไม่จำเป็นต้องคำนวณทุก Match ด้วยมือ
จุดสำคัญคือ:
Probability Model ควรถูกประเมินด้วย Metric ที่สนใจ Probability ไม่ใช่ Accuracy อย่างเดียว
ควรแยก:
Training Data
ใช้สร้างหรือปรับ Model
กับ:
Out-of-Sample / Test Data
ใช้ตรวจ Model ที่ไม่ได้เห็นข้อมูลนั้นตอนพัฒนา
หากปรับ Weight, Features และ Rules ซ้ำ ๆ จนเข้ากับ Historical Dataset เดิมมากเกินไป Model อาจเรียน Noise แทน Signal
นี่เรียกว่า:
Overfitting
Simple Model ที่ผ่าน Out-of-Sample Validation อาจมีประโยชน์มากกว่า Complex Model ที่สวยใน Backtest แต่ล้มเหลวกับข้อมูลใหม่
Data Leakage คือการนำข้อมูลที่ไม่ควรทราบ ณ เวลาทำนายมาใช้ใน Model
ตัวอย่าง:
กำลัง Backtest Pre-Match Forecast
แต่ Dataset มี:
Performance ของ Model จะดูสูงเกินจริง
Rule สำคัญคือ:
Model ณ เวลา Decision ใช้ได้เฉพาะข้อมูลที่ทราบ ณ เวลานั้น
เมื่อมี Independent Probability Estimate แล้วสามารถหา Fair Odds แบบพื้นฐาน:
Fair Odds = 1 ÷ Estimated Probability
ตัวอย่าง:
Probability = 55%
Fair Odds:
1 ÷ 0.55
≈ 1.82
จากจุดนี้จึงค่อยไปประเมิน:
รายละเอียดควรอ่านต่อที่ วิเคราะห์ความคุ้มค่าราคาบอล
บทนี้ไม่จำเป็นต้องคำนวณ EV ซ้ำทุกกรณี เพราะหน้าที่หลักคือสร้าง Probability Input ให้มีหลักการก่อน
เพื่อสาธิต Process ใช้เกมพรีเมียร์ลีก:
Bournemouth vs Liverpool
วันที่ 20 กันยายน 2026
ตัวอย่างนี้ใช้ข้อมูลก่อน Matchday 5 เพื่อหลีกเลี่ยง Hindsight Bias และตั้งใจใช้ Simple Poisson Model สำหรับการศึกษาเท่านั้น
ก่อนการแข่งขัน xG Stat มีข้อมูล 4 เกมลีกแรกของแต่ละทีม โดย Liverpool มีประมาณ 8.9 xG และ 4.7 xGA ส่วน Bournemouth มีประมาณ 7.3 xG และ 5.0 xGA จาก 4 นัด
Bournemouth:
xG/Game:
7.3 ÷ 4
≈ 1.83
xGA/Game:
5.0 ÷ 4
= 1.25
Liverpool:
xG/Game:
8.9 ÷ 4
≈ 2.23
xGA/Game:
4.7 ÷ 4
≈ 1.18
นี่เป็น Sample เพียง 4 เกม จึงยังเล็กมากและควรถูกระบุเป็นข้อจำกัดตั้งแต่ต้น
เพื่อให้เห็น Logic โดยไม่แกล้งทำว่า Model ซับซ้อนกว่าความจริง ตัวอย่างนี้ใช้การเฉลี่ย Attack กับ Opponent Defence
Home λ:
(Bournemouth xG/Game + Liverpool xGA/Game) ÷ 2
(1.83 + 1.18) ÷ 2
≈ 1.50
Away λ:
(Liverpool xG/Game + Bournemouth xGA/Game) ÷ 2
(2.23 + 1.25) ÷ 2
≈ 1.74
ดังนั้น:
λ Home = 1.50
λ Away = 1.74
นี่ไม่ใช่ Production Model เพราะยังไม่ได้ปรับ:
จุดประสงค์คือสาธิต Data → λ → Probability
เมื่อ Home λ = 1.50:
| Bournemouth Goals | Probability |
| 0 | 22.31% |
| 1 | 33.47% |
| 2 | 25.10% |
| 3 | 12.55% |
| 4 | 4.71% |
เมื่อ Liverpool λ ≈ 1.74:
| Liverpool Goals | Probability |
| 0 | 17.60% |
| 1 | 30.57% |
| 2 | 26.56% |
| 3 | 15.38% |
| 4 | 6.68% |
Probability หลักบางส่วน:
| Bournemouth \ Liverpool | 0 | 1 | 2 | 3 |
| 0 | 3.93% | 6.82% | 5.93% | 3.43% |
| 1 | 5.89% | 10.23% | 8.89% | 5.15% |
| 2 | 4.42% | 7.67% | 6.67% | 3.86% |
| 3 | 2.21% | 3.84% | 3.33% | 1.93% |
Score ที่มี Probability สูงสุดใน Matrix ส่วนนี้คือ:
1-1 ≈ 10.23%
แต่ Correct Score ที่มี Probability สูงสุดเพียงประมาณ 10% ก็เป็นตัวอย่างที่ดีว่า แม้ Model จะสร้าง Score Distribution ได้ ก็ไม่ได้หมายความว่าสามารถทำนาย Exact Score ได้แม่นยำสูง
เมื่อนำ Score Matrix ไปขยาย Tail และรวมทุก Score:
Bournemouth Win ≈ 33.41%
Draw ≈ 23.11%
Liverpool Win ≈ 43.48%
รวมประมาณ:
100%
ตาม Simple Model นี้ Liverpool มี Probability สูงสุด แต่ยังต่ำกว่า 50%
จึงไม่ควรแปลงเป็นประโยค:
“Liverpool ต้องชนะ”
จาก λ รวม:
1.50 + 1.74
≈ 3.24 Expected Goals
เมื่อรวม Score ที่มี Total Goals อย่างน้อย 3:
Over 2.5 Probability ≈ 62.79%
นี่เป็น Model Probability ไม่ใช่ Prediction ว่าจะต้องมีอย่างน้อยสามประตู
จาก Simple Independent Poisson:
BTTS Yes ≈ 64.02%
อีกครั้ง ตัวเลขนี้ขึ้นกับ λ และ Independence Assumption
หาก λ เปลี่ยน Probability ก็เปลี่ยนทันที
ผลจริงจบ:
Bournemouth 0-1 Liverpool
และ xG หลังเกมจาก xG Stat อยู่ประมาณ:
Bournemouth 1.03 – 2.05 Liverpool
การที่ Liverpool ชนะไม่ได้พิสูจน์ว่า:
43.48% ถูก
และการที่ Over 2.5 ไม่เกิดไม่ได้พิสูจน์ว่า:
62.79% ผิด
Probability Model ต้องถูกตรวจจาก Forecast จำนวนมาก ไม่ใช่ Outcome เดียว
นี่คือหลัก:
Single Result ≠ Model Validation
Simple Model ด้านบนตั้งใจให้มีข้อจำกัดชัดเจน:
ดังนั้น Probability เหล่านี้ควรเรียกว่า:
Educational Estimate
ไม่ใช่ “True Probability”
ใน Production Model การเริ่มจาก League Baseline สามารถลดปัญหา Small Sample ได้
ตัวอย่างโครงสร้าง:
League Home Goal Rate
×
Home Attack Strength
×
Away Defence Factor
=
Home Expected Goal Rate
แนวคิดเดียวกันใช้กับ Away Team
โดยเฉพาะต้นฤดูกาล เมื่อทีมมีเพียง 3-4 Matches การพึ่ง Team Average อย่างเดียวทำให้ λ ผันผวนมาก
การใช้ Prior หรือ League Baseline จึงเป็นวิธี Shrink Extreme Estimate กลับเข้าหาค่าที่มีข้อมูลมากกว่า
ตัวอย่าง:
ทีมชนะ 4 จาก 5 = เกมหน้ามีโอกาสชนะ 80%
ปัญหาคือ:
แม้สูตร:
4 ÷ 5 = 80%
ถูกทางคณิตศาสตร์
แต่การตีความว่า:
Next Match Probability = 80%
ไม่ได้ตามมาจากข้อมูลนั้นโดยอัตโนมัติ
| วิธี | จุดเด่น | ข้อจำกัด |
| Historical Frequency | ง่ายและโปร่งใส | Context ต่ำ |
| Market-Implied Probability | สะท้อน Market Information | มี Margin และไม่ Independent |
| Statistical Model | รวมหลายปัจจัยได้ | มี Model/Data Risk |
Poisson จัดเป็นหนึ่งใน Statistical Modeling Approaches
ไม่มีวิธีใดควรถูกเรียกว่า “ดีที่สุดเสมอ”
คุณภาพขึ้นอยู่กับ:
Model ที่ Complex มากกว่าไม่ได้แปลว่าดีกว่า
Simple Model ที่:
อาจมีคุณภาพมากกว่า Complex Model ที่ Overfit Historical Data
| ขั้น | สิ่งที่ทำ | Output |
| 1 | กำหนด Outcome | Home/Draw/Away, Goals, BTTS |
| 2 | เลือก Data | Goals, xG/xGA, Venue |
| 3 | กำหนด Sample | Recent + Baseline |
| 4 | ปรับ Opponent | Team Strength |
| 5 | ปรับ Context | Squad/Schedule |
| 6 | สร้าง Goal Rate | λ Home / λ Away |
| 7 | ใช้ Distribution | Score Probability |
| 8 | รวม Outcomes | 1X2 / O-U / BTTS |
| 9 | ประเมิน Uncertainty | Plausible Range |
| 10 | Backtest | Historical Test |
| 11 | Calibrate | Reliability |
| 12 | Test Out-of-Sample | Model Validation |
| 13 | เปรียบ Market | Fair Odds / Value |
Framework แบบสั้น:
Evidence → λ → Distribution → Probability → Calibration
Historical Frequency ไม่ได้รวม Context ใหม่
สร้าง Variance สูง
สูญเสีย Venue Information
Raw Form อาจเกิดจาก Schedule ที่ง่ายหรือยากต่างกัน
xG เป็น Chance Metric ไม่ใช่ 1X2 Probability
λ เป็น Distribution Parameter
ทำให้การประเมิน Value วนกลับไปใช้ Market เป็นคำตอบของตัวเอง
Raw Implied Probabilities สามารถรวมเกิน 100%
เสี่ยง Overfitting
ไม่รู้ว่า Model ทำงานกับข้อมูลใหม่หรือไม่
ใช้ข้อมูลที่ยังไม่ทราบ ณ เวลา Forecast
Probability อาจ Overconfident
55.73% ไม่ได้แปลว่า Model รู้ Probability แม่นถึงสองตำแหน่งทศนิยม
“มั่นใจมาก” ไม่ใช่ 80%
70% ยังมี Failure Probability 30%
| จุดตรวจ | คำถาม |
| Outcome | กำลังประมาณเหตุการณ์อะไร? |
| Data | ข้อมูลมาจากไหน? |
| Sample | มีจำนวน Match เพียงพอไหม? |
| Venue | แยก Home/Away หรือยัง? |
| Opponent | ปรับ Strength หรือไม่? |
| xG | ใช้ Provider เดียวกันหรือไม่? |
| Squad | ข้อมูลล่าสุดหรือยัง? |
| λ | สร้างจาก Method ใด? |
| Assumptions | Independence เหมาะสมแค่ไหน? |
| Range | มี Plausible Range หรือไม่? |
| Calibration | Predicted Probability ตรงกับ Frequency ไหม? |
| Validation | มี Out-of-Sample Test หรือไม่? |
| Leakage | ใช้เฉพาะข้อมูลก่อน Decision หรือไม่? |
| Market | Estimate เป็น Independent จาก Odds จริงหรือไม่? |
| Record | เก็บ Forecast ก่อนทราบ Outcome หรือไม่? |
Q: ชนะ 7 จาก 10 หมายถึงเกมหน้ามีโอกาสชนะ 70% หรือไม่?
A: ไม่ 70% คือ Historical Frequency ของ Sample ส่วน Match ใหม่มี Opponent, Venue, Squad และ Context ใหม่ จึงต้องสร้าง Forecast แยก
Q: ใช้ Odds คำนวณ Probability ได้หรือไม่?
A: ได้ในรูป Market-Implied Probability แต่ต้องคำนึงถึง Margin และไม่ควรเรียกว่า Independent Probability จาก Team Data
Q: xG ใช้คำนวณโอกาสชนะโดยตรงได้หรือไม่?
A: ไม่โดยตรง xG สามารถใช้เป็น Input เพื่อประมาณ Goal Rate ก่อนแปลงเป็น Goal Distribution และ Outcome Probability
Q: Poisson ใช้กับฟุตบอลอย่างไร?
A: ใช้ Expected Goal Rate ของแต่ละทีมสร้าง Distribution ของจำนวนประตู จากนั้นสร้าง Score Matrix และรวม Score เพื่อหา Home Win, Draw, Away Win, Over/Under หรือ BTTS
Q: Probability 60% หมายความว่าทีมจะชนะหรือไม่?
A: ไม่ หมายความว่า Model ประเมิน Outcome ที่ประมาณ 60% ภายใต้ข้อมูลและ Assumptions ที่ใช้
Q: Model ที่ดีควรตรวจอะไร?
A: ควรตรวจ Data Quality, Calibration, Out-of-Sample Performance, Stability และ Assumptions ไม่ใช่ดู Prediction Accuracy อย่างเดียว
Q: ควรใช้ Probability เป็นตัวเลขเดียวหรือช่วง?
A: Point Estimate ใช้งานง่าย แต่เมื่อข้อมูลหรือ Model มีความไม่แน่นอน การรายงาน Plausible Range ช่วยลด False Precision
Q: Brier Score ต่ำแปลว่า Calibration ดีกว่าเสมอหรือไม่?
A: ไม่เสมอ เพราะ Brier Score สะท้อนมากกว่า Calibration เพียงอย่างเดียว จึงควรดู Calibration Curve และ Metric อื่นประกอบด้วย
หัวใจของ การคำนวณความน่าจะเป็นฟุตบอล ไม่ใช่การหาเปอร์เซ็นต์ที่ดูแม่นที่สุด แต่คือสร้าง Estimate ที่อธิบายได้ว่ามาจากข้อมูลและสมมติฐานใด
ลำดับที่เหมาะคือ:
วิเคราะห์ข้อมูล
→ สร้าง Team Strength
→ กำหนด Expected Goal Rate
→ สร้าง Goal Distribution
→ รวมเป็น Outcome Probability
→ ตรวจ Calibration
→ ตรวจ Uncertainty
Historical Win Rate ใช้เป็นข้อมูลได้ แต่ไม่ควรถูกใช้แทน Next-Match Probability
xG ใช้เป็น Model Input ได้ แต่ไม่ใช่ Win Probability โดยตรง
Poisson ช่วยแปลง λ เป็น Score Distribution ได้ แต่คุณภาพของผลลัพธ์ยังขึ้นกับคุณภาพของ λ
และ Probability ที่ดูดีใน Historical Backtest ยังต้องผ่าน Out-of-Sample Test เพื่อป้องกัน Overfitting และ Data Leakage
เมื่อได้ Probability Estimate ที่มี Methodology ชัดเจนแล้ว จึงค่อยนำไปคำนวณ Fair Odds และเปรียบเทียบกับ Market ในบท วิเคราะห์ความคุ้มค่าราคาบอล
ดังนั้น Workflow ที่ครบควรเป็น:
วิธีวิเคราะห์เดิมพันฟุตบอล
→ Probability Model
→ วิธีเลือกเดิมพันฟุตบอล
→ Value Analysis
→ Risk Assessment
ไม่ใช่เริ่มจาก Odds แล้วสร้างเหตุผลย้อนกลับไปหาทีม
แหล่งข้อมูลและ Methodology ที่ใช้จริง:
Case Study: Bournemouth vs Liverpool, Premier League, 20 กันยายน 2026
Pre-Match Window: 4 Premier League Matches แรกของแต่ละทีม
Provider หลักของ Case Study: xG Stat
วันที่ตรวจสอบข้อมูล: 6 ตุลาคม 2026
เนื้อหานี้จัดทำเพื่ออธิบาย Football Statistics, Probability Modeling, Poisson Distribution และการประเมินข้อมูลในเชิงการศึกษา ไม่ใช่การรับประกันผลการแข่งขันหรือคำแนะนำให้เดิมพัน Selection ใด
Probability Estimate ขึ้นอยู่กับ Data, Sample, Model Specification และ Assumptions หาก Input หรือ λ ไม่เหมาะสม Probability ที่คำนวณก็สามารถคลาดเคลื่อนได้ แม้สูตรทางคณิตศาสตร์จะถูกต้อง
Poisson Model แบบง่ายยังมีข้อจำกัด เช่น Independence Assumption, Score Dependence และการเปลี่ยนแปลงของ Team Strength จึงไม่ควรถูกใช้เป็น True Probability โดยไม่ผ่าน Calibration, Validation และ Out-of-Sample Testing
Historical Performance ของ Model ไม่สามารถรับประกัน Future Performance และผลการแข่งขันหนึ่ง Match ไม่เพียงพอสำหรับพิสูจน์ว่า Probability Model ถูกหรือผิด
กิตติพงษ์ ศรีวัฒน์
ผู้เขียนเนื้อหาด้าน Football Statistics, Match Data, xG/xGA และ Probability Modeling โดยเน้นการเปลี่ยนข้อมูลฟุตบอลเป็น Probability Estimate ผ่าน Sample, Venue, Team Strength, Expected Goal Rate และ Statistical Distribution พร้อมตรวจ Calibration, Out-of-Sample Performance และ Model Uncertainty เพื่อป้องกันการตีความเปอร์เซ็นต์เป็นผลลัพธ์ที่แน่นอน


